O Major Incident Management organiza a resposta da TI quando uma falha derruba serviços de alto impacto, e o risco é concreto, já que 57% das organizações pesquisadas pelo Uptime Institute afirmam que a última interrupção grave custou mais de US$ 100 mil.
Para uma em cada cinco, o prejuízo passou de US$ 1 milhão, e a principal causa das falhas ligadas a erro humano é o descumprimento de procedimentos que já existiam, o que coloca a maturidade do processo ao lado da qualidade da infraestrutura.
Este guia mostra como classificar um incidente como crítico, calcular o custo da indisponibilidade, estruturar etapas e papéis de resposta e usar a infraestrutura para reduzir a frequência e o alcance dessas falhas.
CUSTO DA INDISPONIBILIDADE EM NÚMEROS
| > US$ 300 mil
custo médio de uma hora de indisponibilidade para mais de 90% das médias e grandes empresas Fonte: ITIC, 2024 |
41%
das empresas estimam entre US$ 1 milhão e mais de US$ 5 milhões por hora parada Fonte: ITIC, 2024 |
57%
relatam que a última interrupção grave custou mais de US$ 100 mil, e 1 em 5 acima de US$ 1 milhão Fonte: Uptime Institute, 2026 |
Quando um incidente de TI passa a ser considerado crítico?
Um incidente crítico, ou incidente grave, é uma interrupção ou degradação que atinge serviços dos quais o negócio depende e exige resposta acima do fluxo normal de suporte, com prioridade máxima e coordenação entre equipes.
A fronteira entre um incidente comum e um crítico está no efeito sobre o negócio e não no componente que falhou, pois a lentidão em um sistema interno pode esperar o expediente seguinte, enquanto a queda do processamento de pagamentos não pode.
Por isso, a classificação combina impacto e urgência, ou seja, quantos usuários e processos são afetados e em quanto tempo o dano se agrava, e cada empresa traduz isso em níveis de severidade, de P1 (mais grave) a P4.
O SimpleOne ITSM trata disso na versão 1.19 com uma matriz de impacto de negócio, que guia o atendente por perguntas sobre indisponibilidade, abrangência, criticidade do serviço e perfil do solicitante, com critérios ajustáveis.
Quanto custa uma hora de indisponibilidade para a sua empresa?
Na pesquisa de 2024 do ITIC, com mais de mil empresas no mundo, mais de 90% das médias e grandes empresas relatam custo superior a US$ 300 mil por hora de indisponibilidade, valor que não inclui litígios nem penalidades regulatórias.
Para 41% das empresas, a hora parada custa entre US$ 1 milhão e mais de US$ 5 milhões, e nesse patamar cada minuto de atraso na decisão pesa diretamente no resultado financeiro.
Os números globais servem de referência, e o cálculo próprio da sua empresa deve somar a receita não realizada por hora, a mão de obra parada, o esforço de recuperação e as penalidades de SLA, o que justifica o investimento em redundância.
Como estruturar um processo de Major Incident Management em seis etapas
Um processo de Major Incident Management funciona como um circuito fechado, em que cada etapa alimenta a seguinte e a revisão final retorna ao início, na forma de melhorias no monitoramento e nos procedimentos.
CICLO DE RESPOSTA A INCIDENTES CRÍTICOS
| 01
Detecção Alertas de monitoramento e chamados abrem o registro |
02
Classificação Matriz de impacto e urgência define a severidade |
03
Mobilização O incident manager aciona as equipes e distribui os papéis |
| 04
Comunicação Atualizações em intervalos fixos para negócio e clientes |
05
Restauração Contorno, failover ou restauração de backup |
06
Revisão Análise pós-incidente e ações corretivas com prazo |
Detecção e classificação
Todo incidente crítico começa com um sinal, que pode vir de um alerta de monitoramento, de um chamado de usuário ou de um parceiro, e quanto mais cedo o alerta automático dispara, menor é o tempo de exposição do negócio.
Em seguida, o incidente é registrado em uma ferramenta de ITSM e classificado pela matriz de severidade, o que define quem é acionado, em quanto tempo e por qual canal.
Mobilização e papéis
A resposta eficaz depende de papéis definidos antes da crise, e o primeiro deles é o incident manager, também chamado de incident commander, que coordena recursos, decide prioridades e controla a comunicação sem executar a correção técnica.
O tech lead conduz o diagnóstico e a correção, o responsável por comunicação cuida dos avisos a áreas de negócio e clientes e um escrivão registra a linha do tempo, de modo que as decisões possam ser auditadas depois.
Os dados do Uptime Institute reforçam o ponto, pois o descumprimento de procedimentos segue como principal causa das interrupções ligadas a erro humano, o que torna os runbooks testados em simulações um controle direto de risco.
Comunicação durante a crise
Enquanto a equipe técnica trabalha, a comunicação segue um ritmo previsível, com atualizações em intervalos fixos para áreas de negócio, atendimento e clientes, mesmo quando a única novidade é que a investigação continua.
Uma página de status (status page) e um canal único de crise reduzem as perguntas à equipe técnica, e a mensagem inicial deve dizer o que se sabe, o que ainda se investiga e quando haverá nova atualização, sem prometer prazo de correção.
Restauração e revisão pós-incidente
Na restauração, a prioridade é devolver o serviço e a causa raiz fica para depois, o que justifica ações de contorno como rollback de uma mudança recente, failover para outro data center ou restauração de backup.
Com o serviço normalizado, a revisão pós-incidente (post-incident review) reconstrói a linha do tempo, identifica causas e define ações com responsável e prazo, em um formato que busca falhas de processo e não culpados.
Quais indicadores medem a maturidade da resposta a incidentes críticos?
Quatro métricas bastam para iniciar o acompanhamento e todas partem dos registros do ITSM, a saber, o MTTD (tempo médio de detecção), o MTTA (tempo até o reconhecimento), o MTTR (tempo médio de restauração) e a taxa de reincidência.
Como a infraestrutura reduz a frequência e o impacto de incidentes críticos?
O processo reduz o impacto de um incidente e a arquitetura reduz a chance de ele ocorrer, e segundo o Uptime Institute prestadores terceirizados de infraestrutura respondem por cerca de dois terços das interrupções reportadas publicamente.
Esse dado eleva o peso do SLA contratual na escolha do provedor, pois o percentual de disponibilidade, o prazo de resposta e a compensação por violação definem quem assume o custo de cada incidente.
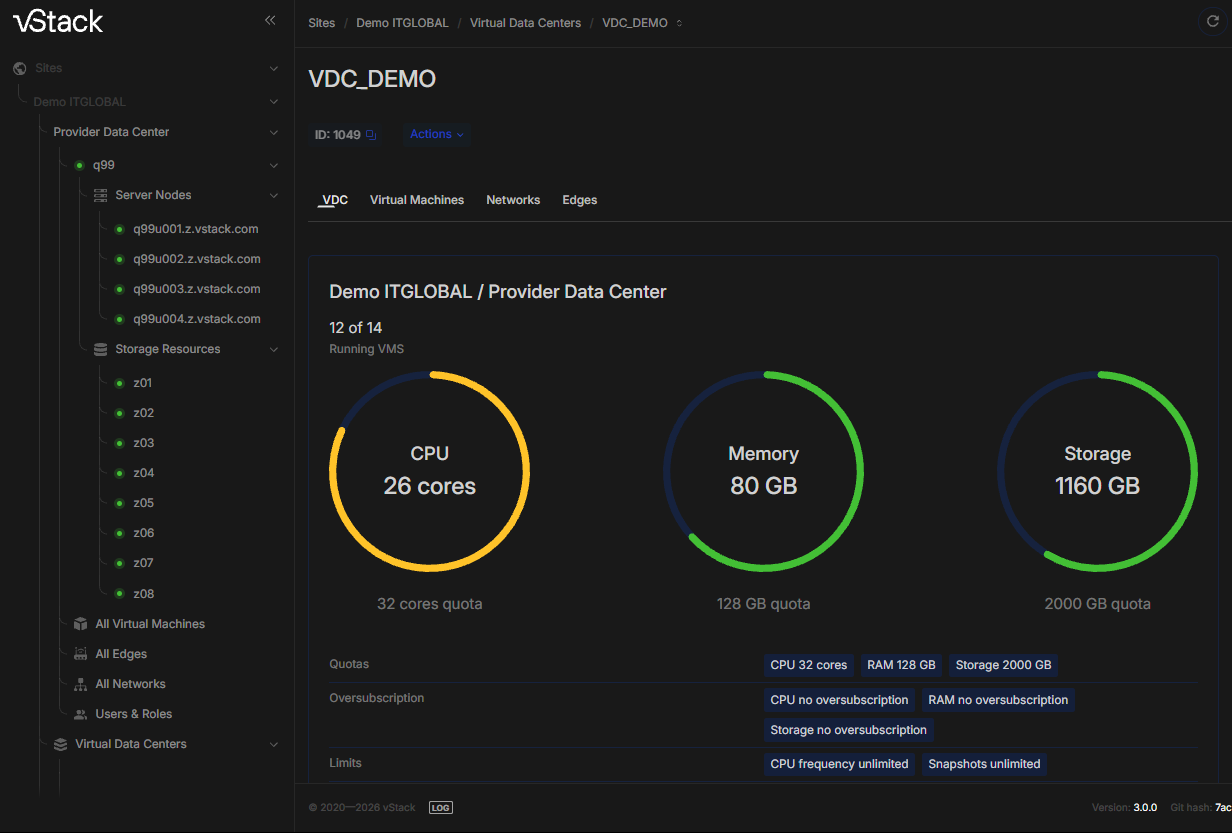
A Cloud da ITGLOBAL.COM opera em data centers parceiros certificados, com energia e comunicação redundantes, em São Paulo, Amsterdam, Nova Jersey, Toronto e Dubai, e conta com as certificações ISO 27001, 27017 e 20000-1.
Para o cenário em que a falha ocorre mesmo assim, os serviços de Disaster Recovery e de backup com Veeam Cloud Connect permitem restaurar cargas de trabalho em outro ambiente, e o RTO e o RPO de cada sistema definem o custo da solução.
O caso da KÉDDO, que adotou uma private cloud de alta disponibilidade com foco em custo-benefício, mostra esse desenho aplicado, e o SimpleOne ITSM cobre a camada de processo, do registro ao histórico usado na revisão pós-incidente.
Resposta estruturada a incidentes críticos protege a continuidade operacional
Um Major Incident Management maduro combina critérios objetivos de classificação, papéis definidos, comunicação previsível e revisão sistemática, e esse conjunto reduz o tempo de restauração justamente quando a hora parada custa mais.
A infraestrutura completa o processo, porque redundância, SLA contratual, backup e Disaster Recovery diminuem a frequência e o alcance das falhas, e o plantão especializado mantém a operação sob supervisão contínua.
A ITGLOBAL.COM atua como extensão do time de infraestrutura do cliente, do diagnóstico do processo à operação da nuvem. Fale com um especialista para avaliar como reduzir o risco de indisponibilidade na sua empresa.
Perguntas frequentes sobre gestão de incidentes críticos
O que é Major Incident Management?
Major Incident Management é o processo de resposta a incidentes de TI que causam impacto grave e imediato no negócio, como a queda de um sistema de pagamentos, e define critérios de classificação, papéis, comunicação e revisão.
Qual é a diferença entre incidente comum e incidente crítico?
Um incidente comum degrada ou interrompe um serviço com impacto limitado e segue o fluxo regular de suporte, enquanto um incidente crítico afeta serviços de grande efeito no negócio e aciona resposta de emergência, com coordenação central.
Quais são as etapas do gerenciamento de incidentes críticos?
As etapas são detecção, classificação, mobilização da equipe, comunicação, restauração do serviço e revisão pós-incidente, executadas em ciclo contínuo e registradas em uma ferramenta de ITSM.
Como reduzir o tempo de restauração (MTTR) em incidentes críticos?
O MTTR diminui com monitoramento que detecta a falha cedo, runbooks testados, papéis definidos, ações de contorno como rollback e failover e uma arquitetura com redundância e Disaster Recovery.